Was ist llms.txt und braucht deine Website eine?
llms.txt ist eine Markdown-Datei unter deine-website.de/llms.txt, die KI-Agenten in wenigen hundert Wörtern sagt, wer du bist und auf welchen Seiten die Fakten stehen. Sie steuert kein Crawling und verbessert kein Ranking. Google sagt, die Google-Suche ignoriert sie. Für die meisten B2B-Unternehmen heißt das: eine Stunde Arbeit, kleiner, unsicherer Nutzen. Meine Empfehlung: Schreib eine, halt sie aktuell und steck den echten Aufwand woanders hin.
Was ist llms.txt?
Jeremy Howard, Mitgründer von fast.ai und Answer.AI, hat den Vorschlag am 3. September 2024 auf llmstxt.org veröffentlicht. Die Idee ist einfach. Webseiten sind für Menschen gebaut. Sie verpacken Informationen in Navigation, Skripte und Cookie-Banner, und das zurück in sauberen Text zu verwandeln ist ungenau. Einem KI-Agenten mit begrenztem Kontextfenster hilft eine kurze, fachkundige Zusammenfassung an einer vorhersehbaren Stelle mehr.
Im August 2026 wechselte der Vorschlag auf Version 2. Die Änderungen zählen, wenn du die Datei richtig umsetzen willst:
- Geltungsbereich nach Pfad. Eine Datei kann im Stammverzeichnis liegen oder in einem Unterordner wie
/docs/llms.txt. Sie gilt für die Seiten unter ihrem Pfad. Agenten sollen die spezifischste Datei verwenden. - Markdown-Kopien von Seiten. Seiten, die Agenten brauchen könnten, sollten eine saubere Markdown-Version unter derselben URL haben, entweder
seite.html.mdoderseite.md. - Auffindbarkeit über Link-Relationen. Eine Seite kann mit
rel="alternate"plustype="text/markdown"auf ihre Markdown-Version zeigen und mitrel="describedby"auf die zuständige llms.txt, als HTML-Link-Element oder als HTTP-Link-Header. - Kein spezielles Werkzeug. Version 1 beschrieb ein Tool, das die Datei zu einem großen Kontextblock aufblies. Version 2 erwartet, dass Agenten die Datei lesen und dann nur den Links folgen, die sie brauchen.
Die Spezifikation selbst sagt, dass llms.txt am stärksten für Software-Dokumentation genutzt wird. Dort folgen Coding-Agenten der Datei, um API-Referenzen zu finden. Sie nennt auch Unternehmensseiten und persönliche Lebenslauf-Seiten als passende Einsatzfälle.
Wie sieht eine llms.txt-Datei aus?
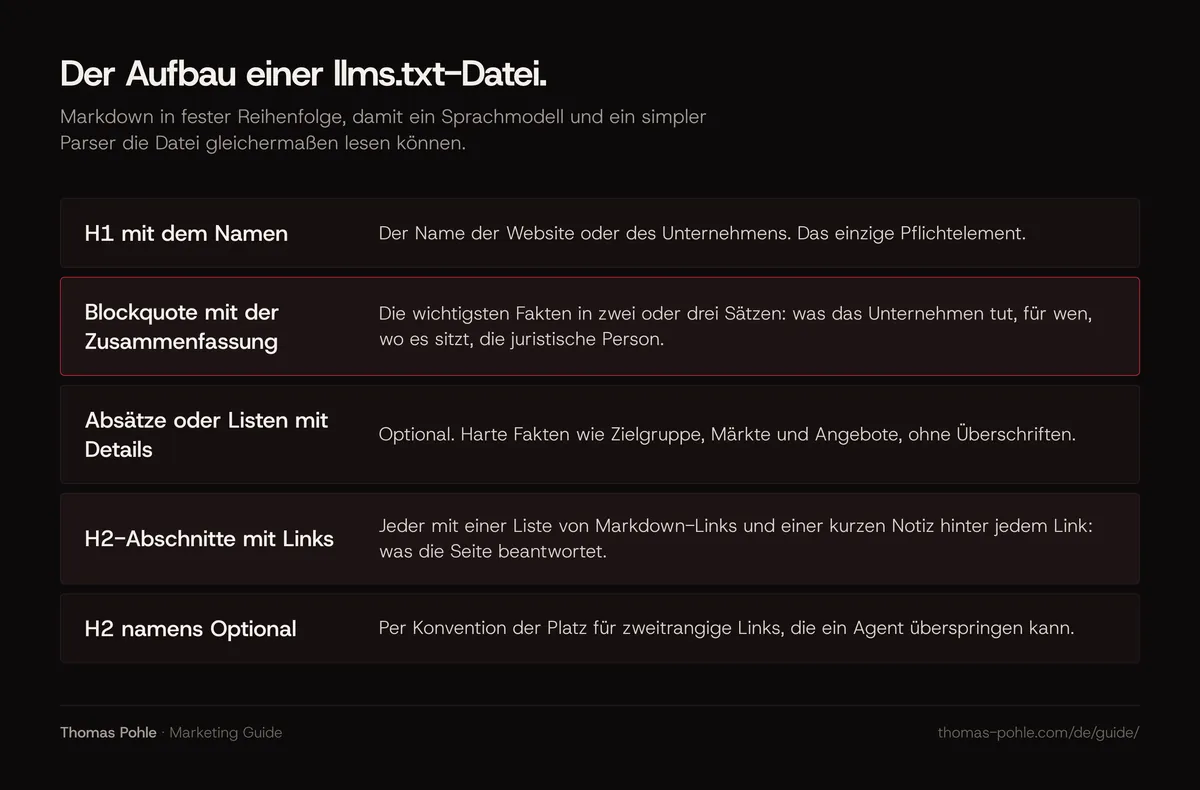
Eine llms.txt-Datei ist Markdown in fester Reihenfolge: eine H1 mit dem Namen, ein Blockquote mit der Zusammenfassung, optionale Absätze mit Details und danach H2-Abschnitte mit Linklisten und einer kurzen Notiz pro Link. Die feste Form ist der ganze Punkt. So lesen ein Sprachmodell und ein simpler Parser die Datei gleichermaßen.
- Eine H1 mit dem Namen der Website oder des Unternehmens. Das ist das einzige Pflichtelement.
- Ein Blockquote mit einer kurzen Zusammenfassung, die die wichtigsten Fakten enthält.
- Optionale Absätze oder Listen mit mehr Details, ohne Überschriften.
- Optionale H2-Abschnitte, jeder mit einer Liste von Markdown-Links und einer kurzen Notiz hinter jedem Link.
- Per Konvention ein H2 namens Optional für zweitrangige Links, die ein Agent überspringen kann.
Hier ist eine gekürzte Fassung der Datei auf dieser Website, eine typische Form für eine kleine B2B-Beratung:
# Thomas Pohle

> B2B marketing advisor based in Zurich. Thomas gets marketing moving with the client's team: workshops, projects and advisory mandates. Legal entity: Pohle Advisory GmbH, Hedingen, Switzerland.

- Audience: founders and CEOs of DACH B2B companies with 1 to 200 people.
- Experience: 10+ years in B2B marketing, in-house at Link11, Beekeeper and smino.

## Formats

- [Momentum Workshop](https://thomas-pohle.com/#how): one day, positioning, ideal customer and the first channel.
- [Momentum Project](https://thomas-pohle.com/#how): four to twelve weeks, one campaign or launch.

## Pages

- [Home](https://thomas-pohle.com/): problem, formats, about, contact.
- [Imprint](https://thomas-pohle.com/imprint.html): legal entity and address.

## Optional

- [TEISENDA](https://teisenda.com/): the AI-native marketing operating system Thomas co-founded.
Dir werden auch Dateien namens llms-full.txt begegnen, die eine ganze Website in eine Datei kippen. Die Spezifikation auf llmstxt.org definiert sie nicht.
Welche KI-Systeme lesen llms.txt tatsächlich?
Kein großer Anbieter von KI-Suche dokumentiert, dass er deine llms.txt liest. Google sagt ausdrücklich, dass die Google-Suche die Datei ignoriert. OpenAI, Anthropic und Perplexity hosten eigene Dateien für ihre Entwickler-Dokumentation. Ob ihre Crawler deine Datei nutzen, sagen sie nicht. An dieser Stelle werden die meisten Artikel vage. Deshalb steht hier, was die Anbieter selbst schreiben, geprüft im Oktober 2026.
| Anbieter | Veröffentlicht eine eigene llms.txt | Sagt, dass er deine nutzt |
|---|---|---|
| Google-Suche (inkl. AI Overviews, AI Mode) | Googles Gemini-API-Dokumentation hat eine | Nein. Google sagt, die Suche ignoriert llms.txt |
| OpenAI | Ja, für die Entwickler-Dokumentation | Nicht dokumentiert. Die Crawler-Dokumentation behandelt User Agents und robots.txt |
| Anthropic | Ja, für die Entwickler-Dokumentation | Nicht dokumentiert. Die Hilfeseite zum Crawler behandelt robots.txt |
| Perplexity | Ja, für die Entwickler-Dokumentation | Nicht dokumentiert. Die Bot-Dokumentation behandelt User Agents und robots.txt |
| Chrome Lighthouse | Nicht anwendbar | Prüft die Datei in den Audits für agentisches Browsen |
Google ist der einzige Anbieter mit einer klaren öffentlichen Position. Sein Leitfaden zur Optimierung für generative KI-Funktionen führt llms.txt unter den Dingen, die du ignorieren kannst. Du brauchst laut Google keine neuen maschinenlesbaren Dateien, KI-Textdateien oder Markdown, um in der Google-Suche zu erscheinen. Eine anzulegen ist in Ordnung. Sie wird deiner Sichtbarkeit weder schaden noch helfen, weil die Google-Suche sie ignoriert. Die separate Seite zu KI-Funktionen ergänzt, dass für AI Overviews oder AI Mode keine besonderen Optimierungen nötig sind.
OpenAI, Anthropic und Perplexity hosten alle llms.txt-Dateien für ihre eigene Entwickler-Dokumentation. Das zeigt, dass sie das Format für Dokumentation und Coding-Agenten nützlich finden. Es zeigt nicht, dass ihre Such-Crawler deine Datei lesen oder damit Zitate auswählen. Keine ihrer Crawler-Seiten sagt das.
Die Prüfung in Chrome Lighthouse ist eng gefasst. Sie meldet einen Serverfehler, wenn Lighthouse die Datei anfordert. Eine fehlende Datei liefert einen 404 und wird als nicht anwendbar markiert, weil die Datei, in Googles Worten, derzeit optional ist.
Plausibel bleibt der Fall der Agenten. Bittet jemand einen KI-Assistenten mit Browsing oder einen Coding-Agenten, sich dein Unternehmen anzusehen, ruft der Agent möglicherweise /llms.txt ab, weil es eine bekannte Konvention ist. Das ist ein echter Nutzen. Er ist aber klein und schwer messbar.
Verbessert llms.txt SEO oder die Sichtbarkeit in KI-Antworten?
Dafür gibt es keinen Beleg aus Primärquellen. Google sagt, für die Suche tut sie es nicht. Die anderen Anbieter sagen nichts. Unabhängige Studien gibt es, aber das sind Log-Analysen von Anbietern über kleine Stichproben von Websites. Darauf würde ich keine Entscheidung stützen. Ich sag’s klar: Wer dir llms.txt als Hebel für Sichtbarkeit verkauft, verkauft dir eine Hoffnung.
Was tatsächlich entscheidet, ob KI-Systeme dich finden und zitieren, ist dokumentiert und langweilig. Crawler brauchen Zugang über robots.txt und dein CDN. Seiten müssen indexiert sein. Content muss die Frage direkt beantworten. Dein Unternehmen muss eine klare Entität mit konsistenten Daten im ganzen Web sein. Der Leitfaden zum Zitiertwerden durch ChatGPT, Perplexity und AI Overviews geht diese Hebel einzeln durch. Der Überblick zur Antwortmaschinen-Optimierung (AEO) erklärt, wie KI-Antworten ihre Quellen auswählen.
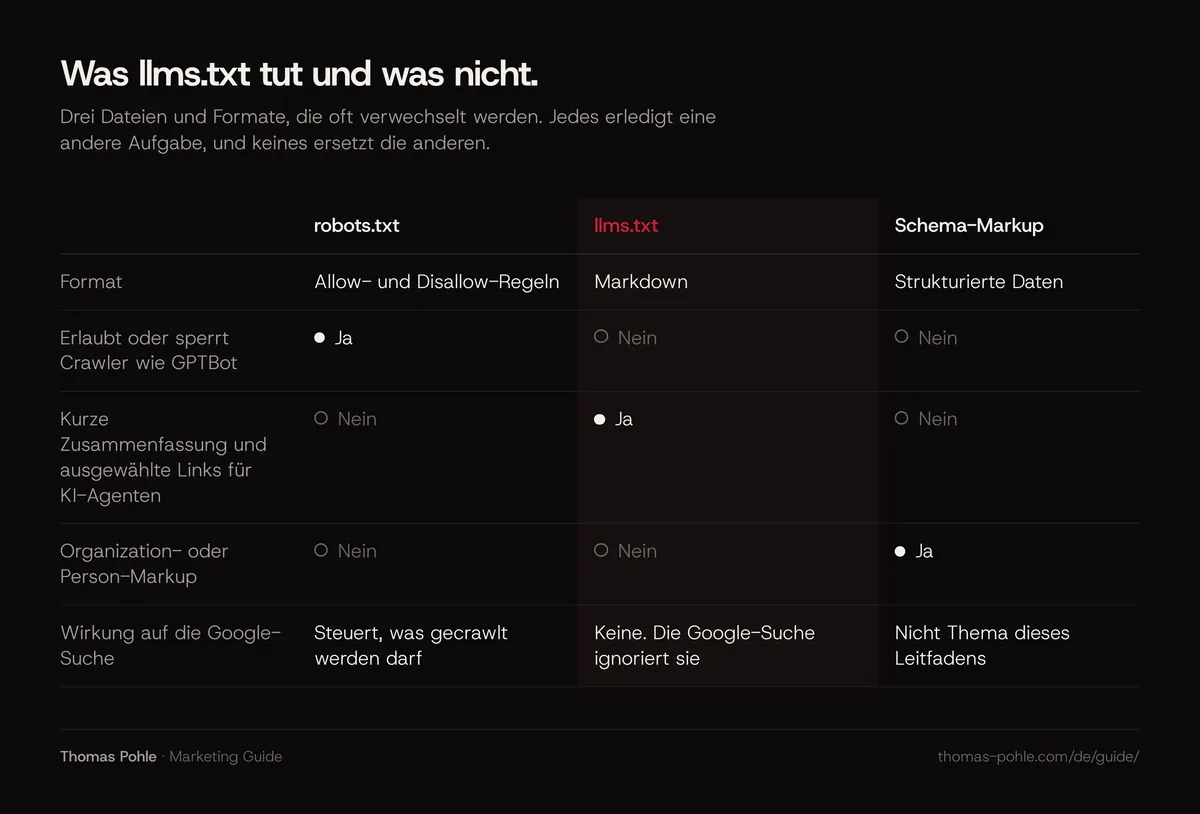
Ein Punkt, der viele verwirrt: llms.txt hat keine Allow- oder Disallow-Regeln. Sie kann GPTBot nicht sperren und PerplexityBot nicht einladen. Den Zugang steuerst du weiterhin in der robots.txt.
Wann lohnt sich llms.txt für ein B2B-Unternehmen?
In drei Situationen lohnt sich die Stunde: Du hast Entwickler-Dokumentation oder eine API, deine Website besteht aus viel Skript und wenig Text, oder dein Unternehmen ist leicht zu verwechseln. In allen drei Fällen gibt eine klare Zusammenfassung an einer bekannten Adresse jedem Agenten, der sie liest, einen verlässlichen Weg zu den Fakten. Das ist meine Einschätzung für B2B.
- Du hast Entwickler-Dokumentation oder eine API. Das ist der ursprüngliche Anwendungsfall, und Coding-Agenten lesen diese Dateien tatsächlich. Dokumentationsplattformen erzeugen oft automatisch eine.
- Deine Website ist schwer an Skripten und leicht an Text. Werden deine Produktseiten clientseitig gerendert, gibt eine saubere Markdown-Zusammenfassung Agenten einen zuverlässigen Pfad zu den Fakten.
- Dein Unternehmen ist leicht zu verwechseln. Ein häufiger Name, ein frisches Rebranding oder eine juristische Person, die anders heißt als die Marke. Eine klare Zusammenfassung mit Firmenname, Standort und Tätigkeit hilft jedem Agenten, der sie liest.
Trifft nichts davon zu, ist die Datei immer noch eine billige Versicherung. Lass dir nur von niemandem einreden, das sei ein Projekt für KI-Sichtbarkeit.
Wie schreibst du diese Woche eine llms.txt-Datei?
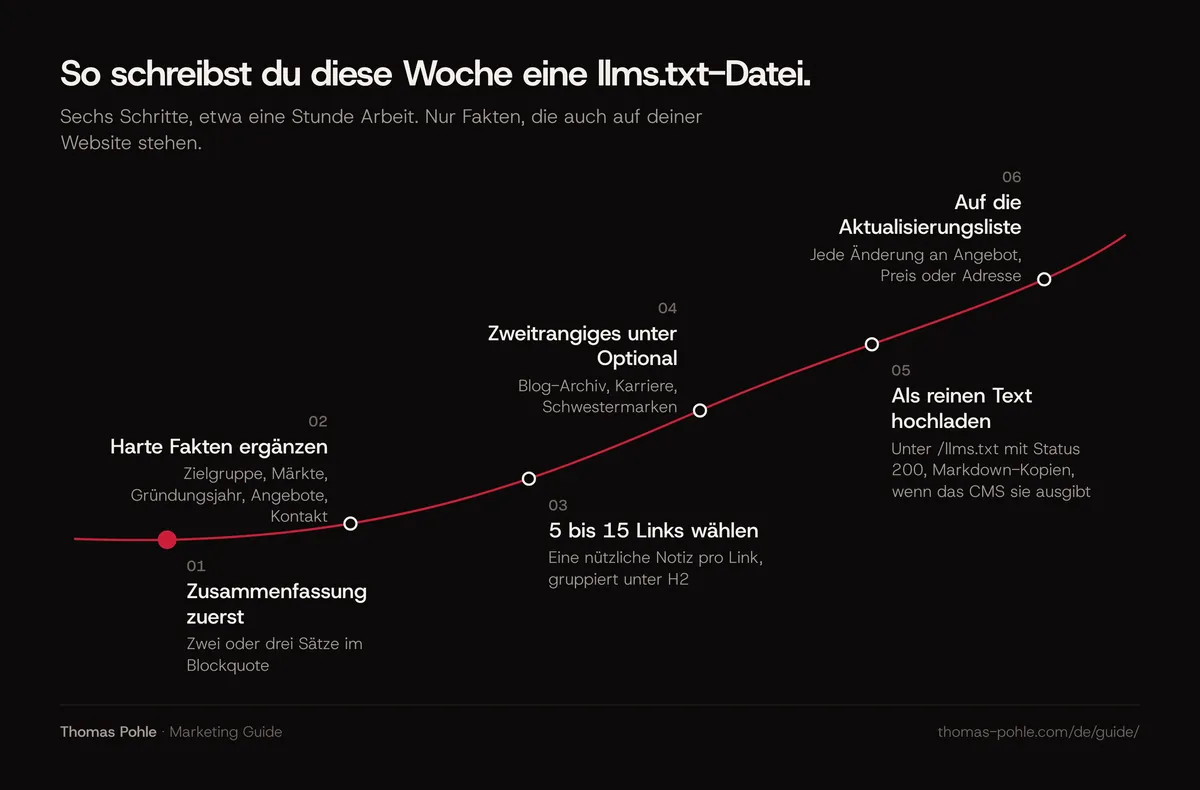
- Schreib zuerst die Zusammenfassung. Zwei oder drei Sätze im Blockquote: was das Unternehmen tut, für wen, wo es sitzt und wie die juristische Person heißt.
- Ergänz harte Fakten als kurze Liste. Zielgruppe, Märkte, Gründungsjahr, Kernangebote, Kontakt. Nur Fakten, die auch auf deiner Website stehen.
- Wähl 5 bis 15 Links. Startseite, Angebote oder Produkte, Preise, falls öffentlich, Über uns, Fallstudien, Kontakt, Impressum. Gruppier sie unter H2-Abschnitten wie Leistungen und Unternehmen.
- Schreib eine nützliche Notiz pro Link. Sag, welche Frage die Seite beantwortet. Slogans haben dort nichts verloren.
- Setz zweitrangige Links unter Optional. Blog-Archiv, Karriere, Schwestermarken.
- Lad die Datei als reinen Text hoch. Liefer sie unter
/llms.txtmit Status 200 und einem Text-Content-Type aus. Prüf sie im Browser und mit Lighthouse, um Serverfehler auszuschließen. - Denk über Markdown-Kopien nach. Kann dein CMS
.md-Versionen wichtiger Seiten ausgeben, verlinke diese und ergänz die Link-Relationen aus Version 2 der Spezifikation. Wenn nicht, verlinke die HTML-Seiten. Das funktioniert auch. - Setz die Datei auf deine Aktualisierungsliste. Jedes Mal, wenn sich ein Angebot, ein Preis oder eine Adresse ändert, ändert sich auch die Datei.
Welche Fehler solltest du vermeiden?
- Der eigenen Website widersprechen. Stehen in der llms.txt 40 Mitarbeitende und auf der Über-uns-Seite 25, hast du genau die Inkonsistenz geschaffen, die du vermeiden wolltest. Strukturierte Daten, Profile und llms.txt sollten alle dieselbe Geschichte erzählen. Der Artikel über Website und Profile zu einer Marke verbinden zeigt, wie.
- Mit Keywords oder Behauptungen vollstopfen. Ein Modell, das eine Liste von Superlativen liest, lernt nichts. Schreib die Datei wie ein Briefing für einen klugen neuen Kollegen.
- Als strukturierte Daten behandeln. llms.txt ersetzt kein Organization- oder Person-Markup. Dafür lies welches Schema-Markup eine B2B-Website braucht.
- Die Grundlagen vergessen. Eine llms.txt auf einer Website, die KI-Crawler blockiert oder Indexierungsprobleme hat, hilft niemandem. Geh zuerst die technische SEO-Checkliste durch.
- Annehmen, dass sie gelesen wird. Prüf deine Server-Logs auf Anfragen an
/llms.txtund notier, welche User Agents sie abrufen. Das sagt dir mehr als jeder Blogbeitrag. Der Leitfaden zum Messen von organischer und KI-Sichtbarkeit erklärt, worauf du achten solltest.
Braucht deine Website also eine?
Brauchen: nein. Nichts in der Dokumentation von Google oder den KI-Anbietern macht llms.txt zur Pflicht, und Google sagt ausdrücklich, dass sie keinen Effekt auf die Suche hat. Wollen: vermutlich ja, wenn du sie als einstündige Hygieneaufgabe behandelst und mit deiner Website synchron hältst. Der Standard ist jung, die Nutzung durch Agenten wächst, und eine korrekte Datei kostet fast nichts.
Willst du lieber zuerst die größeren Hebel sortieren? Positionierung, Entitätsdaten und den Content, den KI-Systeme tatsächlich zitieren. Genau solche Themen bearbeiten wir in einem eintägigen Momentum Workshop.
Häufige Fragen
Ist llms.txt dasselbe wie robots.txt?
Nein. Die robots.txt sagt Crawlern, welche URLs sie abrufen dürfen, und KI-Anbieter wie OpenAI, Anthropic und Perplexity dokumentieren, dass ihre Crawler sie respektieren. llms.txt hat keine Allow- oder Disallow-Regeln. Sie ist eine Markdown-Zusammenfassung mit Links, die einem Agenten hilft, die richtigen Seiten zu finden. Willst du einen KI-Crawler sperren oder zulassen, machst du das weiterhin in der robots.txt.
Nutzt Google llms.txt für AI Overviews?
Nein. Googles Leitfaden in der Search Central zur Optimierung für generative KI-Funktionen sagt, die Google-Suche ignoriert llms.txt-Dateien. Du brauchst keine neuen maschinenlesbaren Dateien, KI-Textdateien oder Markdown, um in der Google-Suche zu erscheinen. Eine anzulegen ist in Ordnung und wird deiner Sichtbarkeit in der Suche weder schaden noch helfen. Das gilt für AI Overviews und AI Mode.
Wo lege ich die llms.txt-Datei ab?
Im Stammverzeichnis deiner Domain, sodass sie unter deinedomain.de/llms.txt lädt, ausgeliefert als reiner Text mit Status 200. Version 2 der Spezifikation erlaubt auch Dateien in Unterordnern, etwa /docs/llms.txt, die dann nur für die Seiten unter diesem Pfad gelten. Treffen mehrere Dateien auf eine Seite zu, sollen Agenten die spezifischste verwenden.
Brauche ich zusätzlich eine llms-full.txt?
Die Spezifikation auf llmstxt.org definiert llms-full.txt nicht. Manche Dokumentationstools erzeugen eine, die den vollständigen Text einer Website in einer Datei enthält. Für eine typische B2B-Marketing-Website bringt das wenig. Version 2 der Spezifikation bevorzugt eine kurze llms.txt, die auf saubere Markdown-Kopien einzelner Seiten verlinkt. So rufen Agenten nur ab, was sie brauchen.
Wie erkenne ich, ob KI-Agenten meine llms.txt lesen?
Schau in deine Server- oder CDN-Logs nach Anfragen an /llms.txt und gruppier sie nach User Agent. Das zeigt dir, welche Bots und Tools die Datei tatsächlich abrufen. Analyse-Tools, die auf JavaScript basieren, sehen diese Anfragen nicht, weil Crawler und Agenten deine Tracking-Skripte in der Regel nicht ausführen. Prüf monatlich und vergleich mit den Anfragen an robots.txt.
Quellen
- The /llms.txt file, v2 (llmstxt.org)
- Changes from v1 to v2 (llmstxt.org)
- Google's guide to optimizing for generative AI features on Google Search
- AI features and your website (Google Search Central)
- Lighthouse: llms.txt audit (Chrome for Developers)
- Overview of OpenAI crawlers
- Does Anthropic crawl data from the web, and how can site owners block the crawler?
- Perplexity crawlers
- llms.txt of thomas-pohle.com
Thomas PohleB2B-Marketingberater in Zürich. Über zehn Jahre B2B-Marketing bei Link11, Beekeeper und smino, zuletzt als Head of Marketing. CEO und Mitgründer von TEISENDA. Mit KI-Werkzeugen recherchiert und entworfen, gegen die oben genannten Quellen geprüft. Mehr über Thomas