Was gehört in eine technische SEO-Checkliste für B2B-Websites?
Eine technische SEO-Checkliste für eine B2B-Website sichert sieben Dinge. Google kann wichtige Seiten crawlen. Es indexiert von jeder die richtige Version und findet sie über eine saubere XML-Sitemap. Es versteht, welche Seite für welche Sprache und welchen Markt gedacht ist. Alles kommt über HTTPS und mit vollem Inhalt auf Mobilgeräten. Und echte Nutzer bekommen eine schnelle, stabile Seite, gemessen als Core Web Vitals.
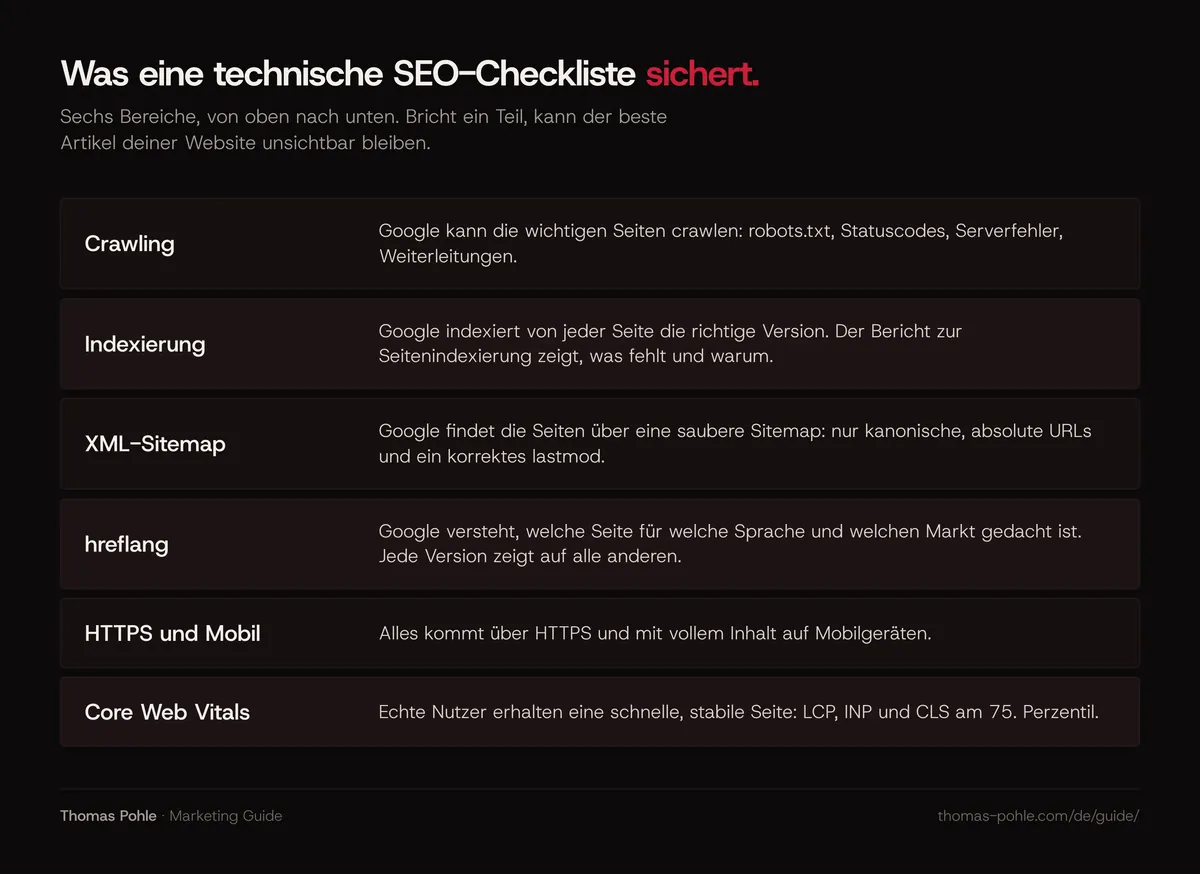
Hält das alles, bekommt dein Content eine faire Chance. Bricht ein Teil, bleibt der beste Artikel deiner Website unsichtbar. Dieser Leitfaden geht jeden Bereich mit dem durch, was Google heute dokumentiert. Am Ende steht eine Checklisten-Tabelle, die du diese Woche abarbeiten kannst.
Warum ist technische SEO für B2B-Websites so wichtig?
Die meisten B2B-Websites sind klein. Ein paar Leistungsseiten, ein Bereich mit Fallstudien, ein Blog, vielleicht ein Ressourcenbereich mit PDFs. Jede Seite trägt mehr Gewicht als auf einer großen Publisher-Website. Ein falsches noindex auf einer Leistungsseite oder eine kaputte Weiterleitung nach einem Relaunch kostet deshalb echte Pipeline.
Technische SEO ist außerdem die Eintrittskarte für die KI-Suche. Google erklärt: Um als unterstützender Link in AI Overviews oder AI Mode zu erscheinen, muss eine Seite indexiert und mit Snippet in der Google-Suche anzeigbar sein. Zusätzliche technische Anforderungen gibt es keine. Dieselben Grundlagen entscheiden also, ob du in klassischen Ergebnissen und in KI-Antworten auftauchst. Das größere Bild findest du hier: was Antwortmaschinen-Optimierung (AEO) ist und wie sie mit SEO zusammenhängt.
Kann Google deine wichtigen Seiten crawlen?
Crawling kommt zuerst. Prüf drei Dinge: Blockiert deine robots.txt etwas, das in der Suche erscheinen soll? Liefern deine wichtigen Seiten den Statuscode 200? Antwortet dein Server stabil? Eine Seite, die Google nicht abrufen kann, wird weder indexiert noch in klassischen Ergebnissen oder in KI-Antworten gezeigt.
- robots.txt. Die Datei sagt Crawlern, welche URLs sie anfordern dürfen. Google ist deutlich: Die robots.txt ist kein Mittel, um eine Seite aus Google herauszuhalten. Eine blockierte URL kann trotzdem in den Ergebnissen erscheinen, ohne Beschreibung, wenn andere Websites darauf verlinken. Willst du eine Seite aus dem Index halten, nimm
noindexoder einen Passwortschutz. - Statuscodes. Deine wichtigen Seiten sollten 200 liefern. Seiten mit einem 4xx-Code fliegen mit der Zeit aus dem Index. Seiten, die 200 liefern, aber leer sind oder wie eine Fehlerseite aussehen, meldet die Search Console als Soft 404.
- Serverfehler. Liefert dein Server 5xx-Fehler oder 429, drosseln Googles Crawler. URLs mit dauerhaften Serverfehlern fallen irgendwann aus dem Index. Wenn dein Hosting schwächelt, behebst du das zuerst. Neuer Content kann warten.
Weiterleitungen verdienen eine eigene Prüfung, besonders nach einem Relaunch oder Domainwechsel. Google wertet einen 301 (und 308) als starkes Signal, dass das Ziel verarbeitet werden soll, einen 302 (und 307) als schwaches. Der Googlebot folgt in der Regel bis zu 10 Weiterleitungsschritten. Meine Faustregel: ein Schritt von jeder alten URL zum neuen Ziel, und 301 für alles Dauerhafte.
Sind die richtigen Seiten indexiert?
Öffne den Bericht zur Seitenindexierung in der Google Search Console. Er zeigt, welche URLs Google indexiert hat und warum andere fehlen. Google sagt klar: Erwarte nicht, dass jede URL deiner Website indexiert wird. Für Tag-Seiten und gefilterte Ansichten ist das in Ordnung. Fehlt eine Leistungsseite oder eine wichtige Fallstudie, hast du ein Problem.
Die Status, die du am häufigsten siehst:
- Gecrawlt, zurzeit nicht indexiert. Google hat die Seite abgerufen und vorerst nicht indexiert. Oft ein Zeichen, dass sie dünn wirkt oder eine andere Seite dupliziert.
- Gefunden, zurzeit nicht indexiert. Google kennt die URL, hat sie aber noch nicht gecrawlt. Bessere interne Links und eine korrekte Sitemap helfen.
- Duplikat, Google hat eine andere kanonische Seite gewählt. Du hast eine kanonische URL erklärt, Google hat eine andere gewählt. Die URL-Prüfung zeigt, welche.
- Durch noindex ausgeschlossen. Korrekt, wenn gewollt. Ein klassischer Relaunch-Fehler, wenn eine Staging-Einstellung live gegangen ist.
Wie richtest du deine XML-Sitemap ein?
Eine Sitemap sagt Google, welche kanonischen URLs du in der Suche haben willst. Sie ist ein Hinweis, keine Garantie: Google verspricht nicht, jede URL darin zu crawlen oder zu indexieren. Googles Regeln für den Aufbau sind kurz. Sie betreffen die Größe der Datei, die Form der URLs, die Auswahl der Einträge und das Datum in lastmod.
- Eine Sitemap-Datei darf bis zu 50.000 URLs oder 50 MB unkomprimiert enthalten. Größere Websites teilen sie auf und nutzen eine Sitemap-Indexdatei.
- Nimm vollständige, absolute URLs, zum Beispiel
https://www.example.com/services/. Relative Pfade gehören nicht hinein. - Liste nur kanonische URLs, die in der Suche erscheinen sollen. Keine Weiterleitungen, keine noindex-Seiten, keine Parameter-Varianten.
- Google nutzt
lastmodnur, wenn es durchgehend und nachprüfbar korrekt ist. Aktualisiere es bei echten Änderungen am Hauptinhalt, an strukturierten Daten oder an Links. Ein neues Copyright-Jahr zählt nicht. - Google ignoriert
priorityundchangefreq. Lass sie weg.
Reich die Sitemap im Sitemaps-Bericht der Search Console ein. Ergänze in der robots.txt eine Zeile Sitemap: mit der vollständigen URL. Und vergiss nicht: Eine Sitemap bleibt ein Hinweis. Google garantiert nicht, jede URL darin zu crawlen oder zu indexieren.
Wie gehst du mit doppelten URLs und Canonical-Tags um?
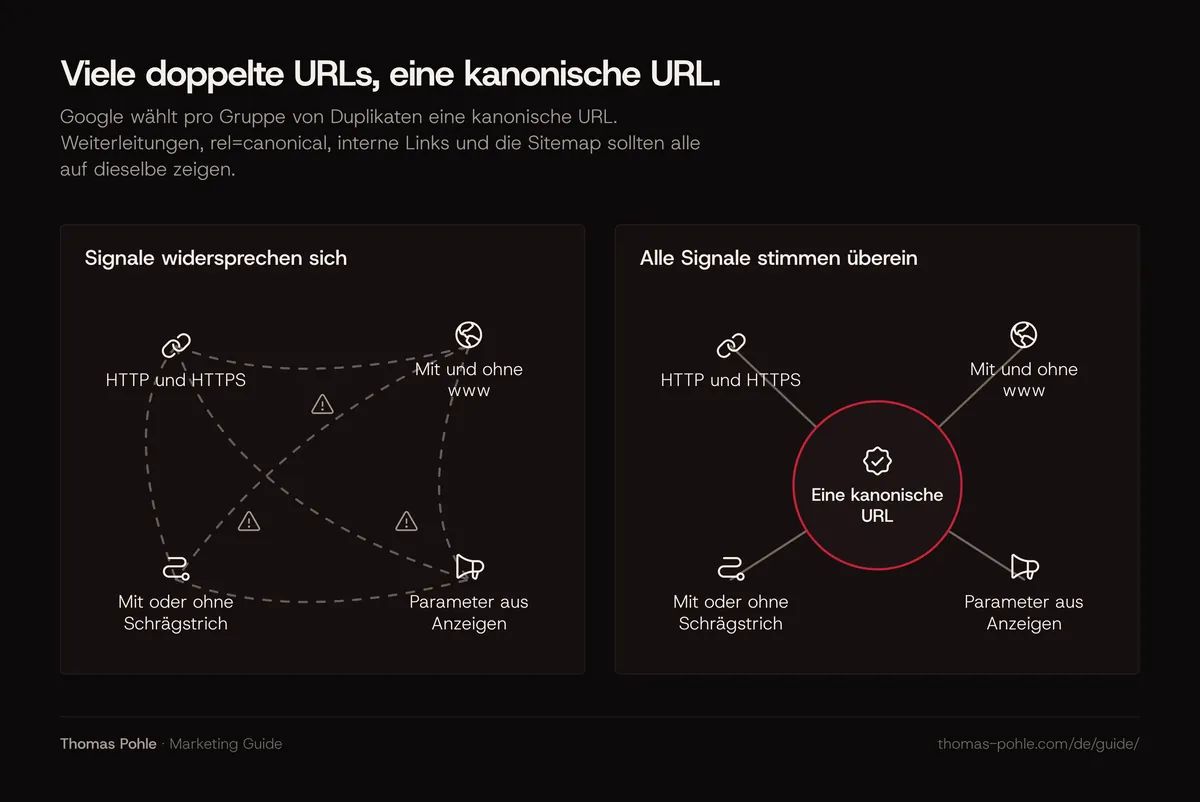
B2B-Websites erzeugen Duplikate, ohne dass es jemand merkt. HTTP und HTTPS, mit und ohne www, mit oder ohne Schrägstrich am Ende, Kampagnenparameter aus LinkedIn-Anzeigen, dasselbe Whitepaper als Landingpage und als PDF. Google wählt pro Gruppe von Duplikaten eine kanonische URL. Du beeinflusst diese Wahl mit Signalen unterschiedlicher Stärke:
- Weiterleitungen sind ein starkes Signal. Nutz sie, wenn du ein Duplikat stilllegst.
rel="canonical"ist ein starkes Signal. Es funktioniert im HTML-Head und als HTTP-Header, praktisch für PDFs.- Aufnahme in die Sitemap ist ein schwaches Signal.
Google rät davon ab, robots.txt oder noindex zur Kanonisierung zu nutzen. Ein noindex entfernt die Seite komplett aus der Suche, statt sie zusammenzuführen. Canonical-Tags sind starke Hinweise, mehr nicht. Google kann trotzdem eine andere URL wählen, wenn deine übrigen Signale woandershin zeigen, etwa interne Links und Sitemap-Einträge. Bring alle in Einklang.
Wie richtest du hreflang für DACH und andere Märkte ein?
Bedienst du die Schweiz, Deutschland und englischsprachige Märkte, sagt hreflang Google, welche Seitenversion zu welcher Sprache und Region passt. Google unterstützt drei gleichwertige Methoden: link-Elemente im HTML-Head, HTTP-Header oder die XML-Sitemap. Wähl eine und bleib dabei. Die Regeln sind wenige, aber jede einzelne muss stimmen.
- Jede Version listet sich selbst und alle Alternativen. Zeigt Seite A auf Seite B, aber B nicht zurück, kann Google die Angaben ignorieren.
- Nimm vollständige URLs inklusive Protokoll. Alternativen dürfen auf unterschiedlichen Domains liegen.
- Codes bestehen aus einem Sprachcode nach ISO 639-1, optional gefolgt von einem Regionscode nach ISO 3166-1 Alpha 2, zum Beispiel
de-CH,de-DEoderen. Ein Regionscode allein ist ungültig. - Ergänze
x-defaultfür Besucher, deren Sprache zu keiner deiner Versionen passt. Meist ist das deine Sprachauswahl oder die englische Hauptseite.
Ein Detail, das viele Teams übersehen: Google nutzt weder hreflang noch das HTML-Attribut lang, um die Sprache einer Seite zu erkennen. Es liest den Inhalt. Eine deutsche URL mit englischem Fließtext ist für Google eine englische Seite. Ich habe Marketing für acht Märkte verantwortet. Meine Faustregel daraus: Prüf zuerst die Rückverweise. Vergisst eine Version, zurückzuzeigen, scheitert hreflang ohne sichtbaren Fehler.
Welche Core-Web-Vitals-Schwellen musst du erreichen?
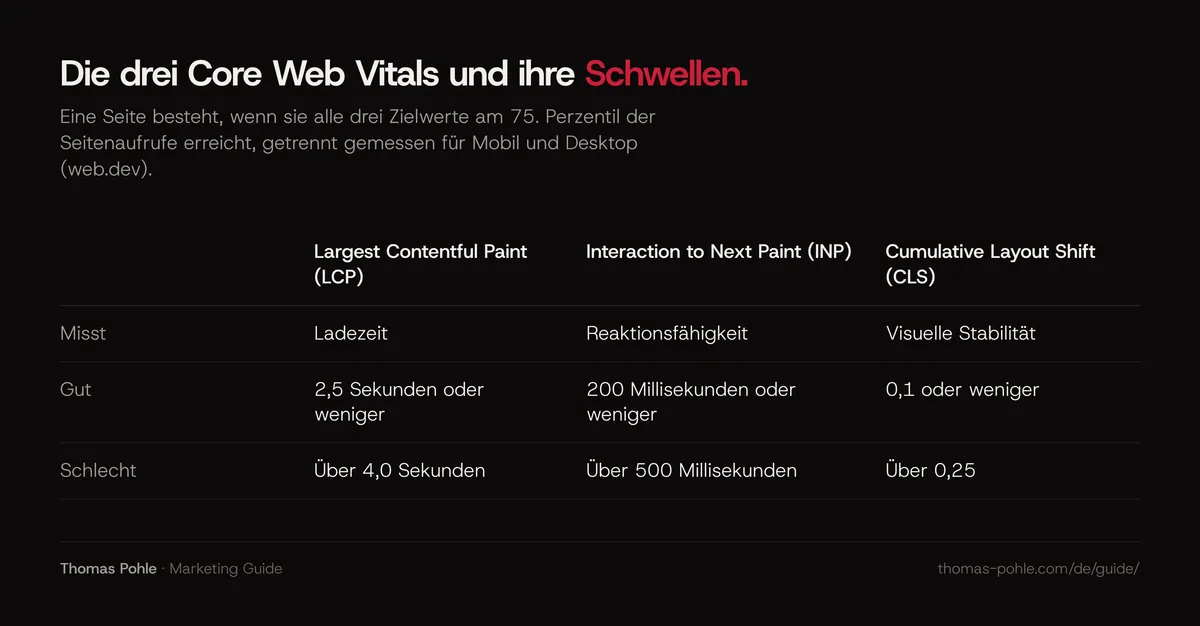
Core Web Vitals messen die echte Nutzererfahrung. Laut web.dev besteht eine Seite, wenn sie alle drei Zielwerte am 75. Perzentil der Seitenaufrufe erreicht, getrennt gemessen für Mobil und Desktop: LCP bis 2,5 Sekunden, INP bis 200 Millisekunden und CLS bis 0,1. Für B2B-Websites sind das Hygienewerte. Einmal grün bekommen, dann überwachen.
- Largest Contentful Paint (LCP), Ladezeit: gut bei 2,5 Sekunden oder weniger, schlecht über 4,0 Sekunden.
- Interaction to Next Paint (INP), Reaktionsfähigkeit: gut bei 200 Millisekunden oder weniger, schlecht über 500 Millisekunden.
- Cumulative Layout Shift (CLS), visuelle Stabilität: gut bei 0,1 oder weniger, schlecht über 0,25.
INP hat First Input Delay (FID) im März 2024 als Core Web Vital abgelöst. Zeigt ein Agenturbericht oder ein altes Plugin noch FID, ist er veraltet.
Wie stark wirkt das auf das Ranking? Google sagt, seine Ranking-Systeme nutzen Core Web Vitals. Es sagt aber auch, dass gute Werte keine Spitzenpositionen garantieren. Relevanter Content kann auch mit schwächerer Seitenerfahrung ranken. Meine Meinung: Im B2B sind Core Web Vitals ein Hygienefaktor. Grün bekommen, dann die Zeit in Content stecken.
Der Core-Web-Vitals-Bericht der Search Console nutzt Felddaten aus dem Chrome UX Report und gruppiert ähnliche URLs. Kleineren B2B-Websites fehlt oft genug Traffic pro URL. Dann fällt der Bericht auf Daten für die ganze Domain zurück. Für die Fehlersuche auf Seitenebene nimmst du Lighthouse oder PageSpeed Insights. Schau auf die üblichen Verdächtigen: übergroße Hero-Bilder und Videos, renderblockierende Skripte, Cookie-Banner und Chat-Widgets, die das Layout verschieben oder die Interaktion verzögern.
Spielen HTTPS und Mobil noch eine Rolle?
Ja. Google führt sichere Auslieferung in seiner Selbsteinschätzung zur Seitenerfahrung auf und bietet in der Search Console einen HTTPS-Bericht an. Für eine B2B-Website zählen vor allem Vertrauen und Funktion. Browser warnen bei unsicheren Formularen. Ein Demo-Anfrageformular über HTTP ist ein Lead, den du verlierst. Prüf den HTTPS-Bericht in der Search Console und beheb Mixed Content.
Mobil zählt, weil Google mit der mobilen Version einer Seite indexiert und rankt, gecrawlt mit seinem Smartphone-Agenten. Mit responsivem Design bist du weitgehend abgedeckt. Versteckst du auf Mobil Inhalte, lässt strukturierte Daten weg oder nutzt andere Titel und Meta-Beschreibungen, sieht Google die reduzierte Version. Halte Hauptinhalt, Überschriften, strukturierte Daten und Metadaten auf Mobil und Desktop gleichwertig. Akkordeons und Tabs sind für lange Inhalte in Ordnung.
Was solltest du jeden Monat in der Search Console prüfen?
Leg dir einen festen Termin von 30 Minuten pro Monat und schau dir fünf Dinge an: Seitenindexierung, Sitemaps, die Berichte zu Core Web Vitals und HTTPS, die URL-Prüfung für jede neue Leistungsseite und die Verbesserungsberichte für strukturierte Daten. Für eine Website mit ein paar hundert Seiten reicht das. So siehst du Probleme, bevor sie Pipeline kosten.
- Seitenindexierung: Sind neue oder wichtige URLs indexiert? Gibt es neue noindex- oder Soft-404-Probleme?
- Sitemaps: Datum des letzten Lesens und Fehler.
- Berichte zu Core Web Vitals und HTTPS: URL-Gruppen, die auf schlecht gekippt sind.
- URL-Prüfung für jede neue Leistungsseite oder größere Aktualisierung.
- Verbesserungsberichte für deine strukturierten Daten. Die Details stehen in welches Schema-Markup eine B2B-Website braucht.
Für ein schlankes Reporting, das auch Bing und KI-Referrals abdeckt, lies, wie du organische und KI-Sichtbarkeit misst.
Die technische SEO-Checkliste für diese Woche
| Bereich | Prüfung | Wo prüfen |
|---|---|---|
| Crawling | robots.txt blockiert nichts, was in die Suche soll, und nennt deine Sitemap | robots.txt-Datei, robots.txt-Bericht in der Search Console |
| Statuscodes | Wichtige Seiten liefern 200, stillgelegte Seiten 301 oder 404/410, keine Soft 404 | Bericht zur Seitenindexierung, ein Crawler wie Screaming Frog |
| Weiterleitungen | Ein Schritt von alter zu neuer URL, 301 für dauerhafte Umzüge | Crawler, Netzwerk-Tab im Browser |
| Indexierung | Jede Leistungs-, Produkt- und Fallstudienseite ist indexiert | Bericht zur Seitenindexierung, URL-Prüfung |
| noindex | Kein übrig gebliebenes noindex vom Staging | URL-Prüfung, Seitenquelltext |
| Sitemap | Nur kanonische, indexierbare, absolute URLs, korrektes lastmod | Sitemaps-Bericht |
| Canonicals | Eine kanonische URL pro Seite, passend zu internen Links und Sitemap | URL-Prüfung (von Google gewählte kanonische URL) |
| Duplikate | HTTP-, Nicht-www- und Schrägstrich-Varianten leiten auf eine Version weiter | Browser, Crawler |
| hreflang | Selbstverweis, Rückverweise, gültige Codes, x-default | Seitenquelltext oder Sitemap, hreflang-Bericht des Crawlers |
| Core Web Vitals | LCP bis 2,5 s, INP bis 200 ms, CLS bis 0,1 am 75. Perzentil | Core-Web-Vitals-Bericht, PageSpeed Insights |
| HTTPS | Alle Seiten und Formulare über HTTPS, kein Mixed Content | HTTPS-Bericht in der Search Console |
| Mobil | Gleicher Inhalt, gleiche Überschriften, strukturierte Daten und Metadaten wie am Desktop | URL-Prüfung (gerenderte Seite), Lighthouse |
| Strukturierte Daten | Gültiges Markup, das zum sichtbaren Inhalt passt | Test für Rich Results, Verbesserungsberichte |
| Interne Links | Keine verwaisten Seiten, wichtige Seiten wenige Klicks von der Startseite entfernt | Crawler |
Was kommt nach den technischen Grundlagen?
Ist die Checkliste grün, wird technische SEO zur Wartung. Geh sie nach jedem Relaunch, jeder CMS-Migration und jedem neuen Markt durch. Die nächsten Gewinne kommen aus Struktur und Content: eine klare Seitenarchitektur mit Themenclustern und interner Verlinkung, strukturierte Daten, die Unternehmen und Leute beschreiben, und Seiten, die echte Käuferfragen so gut beantworten, dass KI-Assistenten sie zitieren.
Du willst ein zweites Paar Augen auf dein Setup und einen priorisierten Plan? Genau das klären wir in einem eintägigen Momentum Workshop.
Häufige Fragen
Wie oft sollte ein B2B-Unternehmen ein technisches SEO-Audit machen?
Mach eine vollständige Prüfung nach jedem Relaunch, jeder CMS-Migration, jedem Domainwechsel und jedem Start in einem neuen Markt. Genau dann brechen Weiterleitungen, Canonicals und noindex-Einstellungen. Dazwischen reicht für eine Website mit ein paar hundert Seiten meist ein monatlicher Blick von 30 Minuten auf die Berichte zu Seitenindexierung, Sitemaps, Core Web Vitals und HTTPS in der Google Search Console.
Hält die robots.txt eine Seite aus Google heraus?
Nein. Google erklärt, dass die robots.txt kein Mittel ist, um eine Webseite aus Google herauszuhalten. Sie steuert das Crawling. Eine blockierte URL kann trotzdem ohne Beschreibung in den Ergebnissen erscheinen, wenn andere Seiten darauf verlinken. Willst du eine Seite aus dem Index halten, nimm ein noindex-Robots-Meta-Tag oder einen entsprechenden Header, oder leg die Seite hinter ein Passwort.
Ist FID noch ein Core Web Vital?
Nein. Interaction to Next Paint (INP) hat First Input Delay (FID) im März 2024 als Core Web Vital abgelöst. Die drei aktuellen Metriken sind LCP (gut bei 2,5 Sekunden oder weniger), INP (gut bei 200 Millisekunden oder weniger) und CLS (gut bei 0,1 oder weniger), jeweils bewertet am 75. Perzentil der Seitenaufrufe auf Mobil und Desktop.
Brauche ich hreflang, wenn meine Website nur Deutsch und Englisch hat?
Ja, sobald du gleichwertige Seiten in beiden Sprachen hast. hreflang hilft Google, die deutsche Seite Deutschsprachigen zu zeigen und die englische allen anderen. Sprichst du Schweizer und deutsches Publikum mit unterschiedlichen Seiten an, nimm Regionscodes wie de-CH und de-DE. Jede Version muss auf sich selbst und alle Alternativen verweisen. Ergänze außerdem ein x-default.
Beeinflusst technische SEO die Sichtbarkeit in AI Overviews?
Ja, indirekt. Google sagt, eine Seite muss indexiert und mit Snippet anzeigbar sein, um als unterstützender Link in AI Overviews oder AI Mode zu erscheinen. Zusätzliche technische Anforderungen gibt es keine. Eine blockierte, auf noindex gesetzte oder nicht indexierte Seite fällt raus. Die grundlegenden Prüfungen zu Crawling und Indexierung gelten also auch für KI-Funktionen.
Quellen
- Google Search Central: Introduction to robots.txt
- Google Search Central: How HTTP status codes and network errors affect Google Search
- Google Search Central: Build and submit a sitemap
- Google Search Central: How to specify a canonical URL
- Google Search Central: Tell Google about localized versions of your page
- web.dev: Web Vitals
- web.dev: Interaction to Next Paint is officially a Core Web Vital
- Google Search Central: Understanding page experience in Google Search results
- Google Search Central: Mobile-first indexing best practices
- Google Search Central: AI features and your website
Thomas PohleB2B-Marketingberater in Zürich. Über zehn Jahre B2B-Marketing bei Link11, Beekeeper und smino, zuletzt als Head of Marketing. CEO und Mitgründer von TEISENDA. Mit KI-Werkzeugen recherchiert und entworfen, gegen die oben genannten Quellen geprüft. Mehr über Thomas